1.背景
既存のLLM(大規模言語モデル)を特定の用途やタスクに合わせて調整する作業のことをチューニングと呼びます。チューニングには、出力の形式を整える、特定タスクの精度を向上させる、といった幾つかの観点があり、目的に応じた手法が用いられます。
その中でも特に難易度が高いのが、LLMに新たな専門知識を定着させ、業界特有の知識に詳しいモデルを作ることです。例えば、業務マニュアルや専門書の内容をモデルに覚えさせたい場合がこれにあたります。
知識の付与には、モデル全体を再学習させる手法が一般的ですが、これには極めて膨大な量のデータが必要です。A4用紙のテキスト1ページが数キロバイトである中、数十ギガバイト(1千万倍)を超えるようなデータを用います。
実際の業務現場で、これほど大量の業務マニュアルや資料を用意するのは困難です。インターネット上から類似情報を集めようとしても、業務と無関係な情報が混入しやすく、高品質なデータセットを構築するのは容易ではありません。そのため、各社が所有する限られた業務資料のみから、LLMに効率的に知識を定着させるためのチューニング手法が求められています。
2.技術のポイント
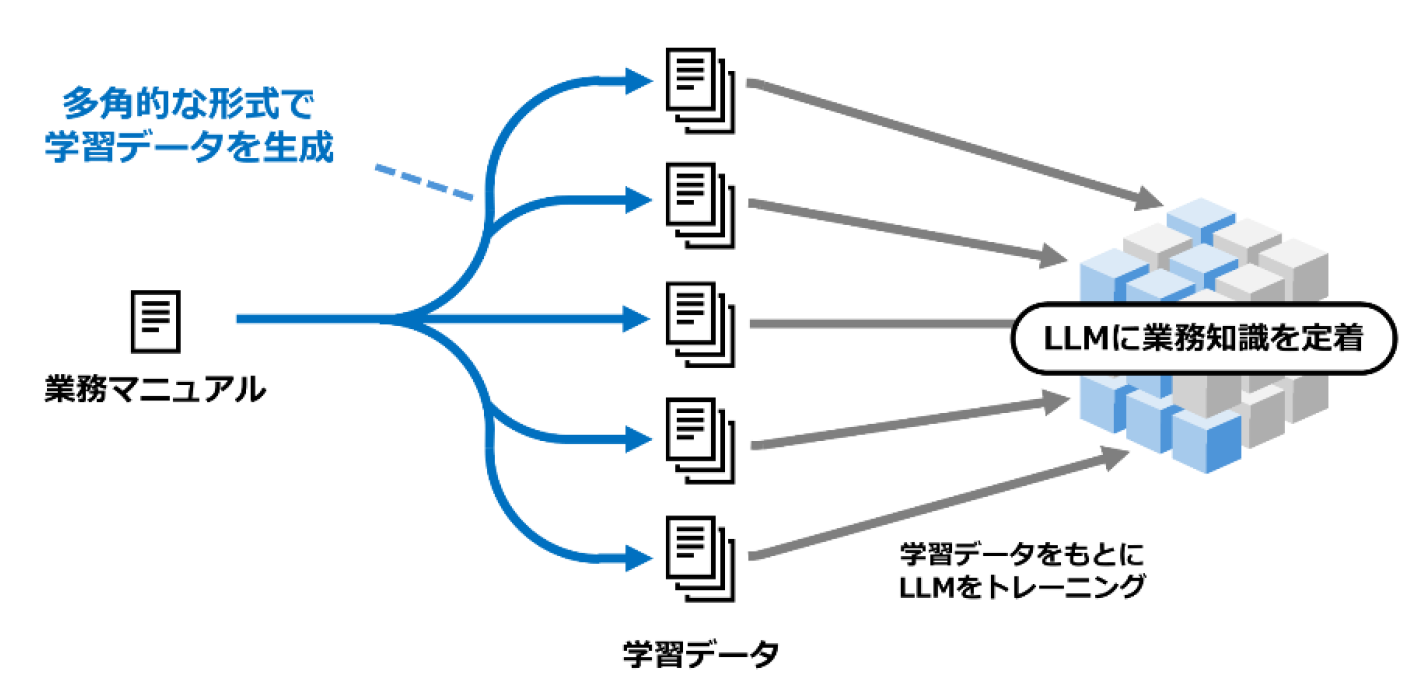
本技術は、お客様問い合わせマニュアルなどの業務知識を記載したドキュメントを活用し、LLMがその内容を深く理解できるように設計されています。そのポイントは多角的な学びです。例えば学校の国語の授業では、文章を読むことに加え、著者の意図を理解するための設問を用意したり、生徒間で感想を述べ合ったりと様々な様式で学びを深めます。本技術はこのような着想に基づいて、LLM自身に業務マニュアルを学ぶための教材(学習データ)を多角的に構築させ、自らの学びに活用させます。業務マニュアルから、仕様書、FAQといった多様な表現形式のデータを生成するなどします。こうして生成されたデータを用いて学習を行うことで、従来よりも高精度にマニュアルに記載された知識を獲得することができるようになりました。
3.実験の概要
NTTの実業務マニュアルを与え、その知識の定着度合いを計測しました。知識の定着率は、この業務マニュアルに記載範囲内の問題を作り、LLMに解かせて、その正答率を計測しました。LLMには、tsuzumi 2とLlama 3(3B)を用いて、それぞれ学習前後の正答率を比較しました。
tsuzumi 2において、学習前(業務マニュアルを与える前)の正答率は65.3%でした。先行研究では最大73.3%まで向上しましたが、本技術を用いることで83.1%と、さらに10%近く正答率を向上させることができました。
特化モデルは、基本的な性能が低くなりがちな軽量モデルほど実施の必要性が高いことを鑑みて、tsuzumi 2よりも軽量なモデルであるLlama 3(3B)でも評価を行いました。同様に先行研究よりも優れていることを確認しています。
[比較手法]
・先行研究※2:本技術とは異なる観点で学習データを生成する手法
・従来手法:オリジナルデータ(業務マニュアル)を繰り返し利用する手法
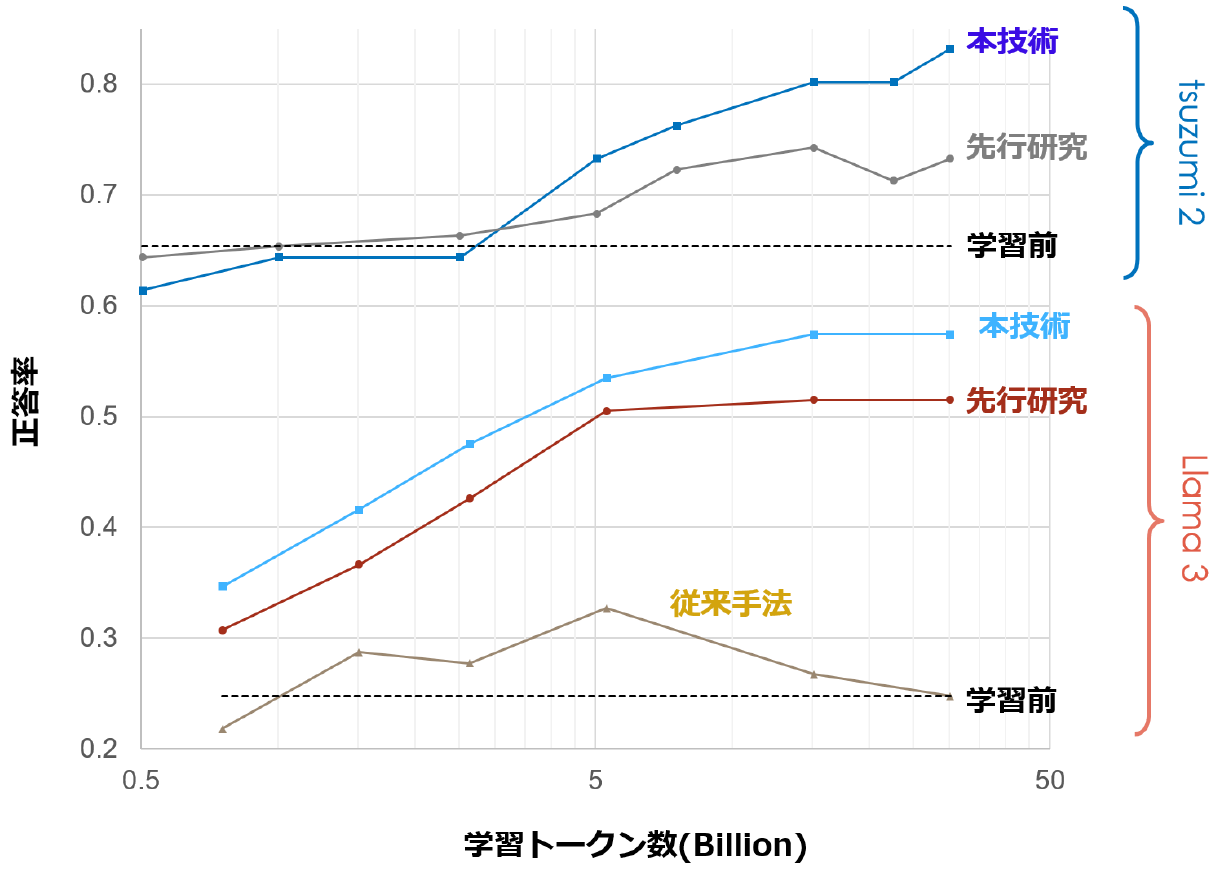
図2.業務マニュアルの知識を問う問題の正答率。横軸はチューニング時に与えたデータ量。